
🎧 Listen to this article: हिंदी · English · தமிழ் · తెలుగు · ಕನ್ನಡ · മലയാളം · ଓଡ଼ିଆ · 日本語 · 中文
🌍 Read this in your language: हिंदी · தமிழ் · తెలుగు · ಕನ್ನಡ · മലയാളം · ଓଡ଼ିଆ · 日本語 · 中文
ಆಧುನಿಕ ಅಪ್ಲಿಕೇಶನ್ಗಳು ಕೇವಲ ಪಠ್ಯವನ್ನು ಮಾತ್ರವಲ್ಲದೆ ಅರ್ಥವನ್ನು ಹೇಗೆ ಅರ್ಥಮಾಡಿಕೊಳ್ಳುತ್ತವೆ ಎಂಬುದರ ಕುರಿತು ತಾಂತ್ರಿಕ ಆಳವಾದ ಪರಿಶೀಲನೆ
ಇದು ಈಗೇಕೆ ಪ್ರಮುಖವಾಗಿದೆ (ಜೂನ್ 2026)
2026 ರ ಮಧ್ಯಭಾಗದ ವೇಳೆಗೆ, ನಾವು ಕೃತಕ ಬುದ್ಧಿಮತ್ತೆಯು (AI) ಹೊಸತನವಾಗಿರುವುದನ್ನು ನಿಲ್ಲಿಸಿ ಮೂಲಸೌಕರ್ಯವಾಗಿ ಮಾರ್ಪಟ್ಟಿರುವ ಯುಗದಲ್ಲಿ ವಾಸಿಸುತ್ತಿದ್ದೇವೆ. ನಿಮ್ಮ ಸರ್ಚ್ ಎಂಜಿನ್ ಉದ್ದೇಶವನ್ನು ಅರ್ಥಮಾಡಿಕೊಳ್ಳುತ್ತದೆ. ನೀವು ಕ್ಲಿಕ್ ಮಾಡುವ ಮೊದಲು ನಿಮಗೆ ಏನು ಇಷ್ಟವಾಗುತ್ತದೆ ಎಂದು ನಿಮ್ಮ ಶಿಫಾರಸು ವ್ಯವಸ್ಥೆಗೆ ತಿಳಿದಿರುತ್ತದೆ. ನಿಮ್ಮ ಸೈಬರ್ ಭದ್ರತಾ ವ್ಯವಸ್ಥೆಯು ತಿಳಿದಿರುವ ದಾಳಿಯ ಮಾದರಿಗಳಿಗೆ ಹೊಂದಿಕೆಯಾಗದಿದ್ದರೂ ಸಹ "ವಿಚಿತ್ರ" ಎಂದು ಕಾಣುವ ಬೆದರಿಕೆಗಳನ್ನು ಪತ್ತೆಹಚ್ಚುತ್ತದೆ.
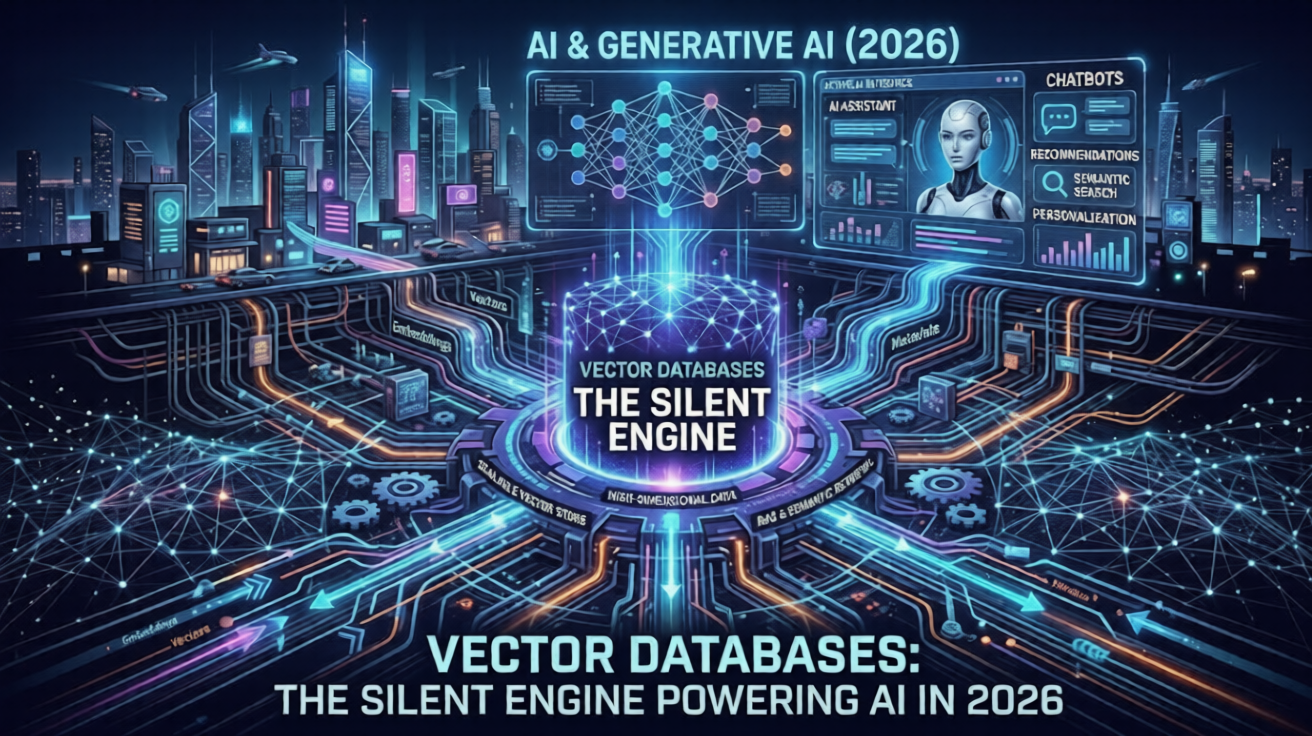
ಈ ಎಲ್ಲದರ ಹಿಂದೆ ಏನಿದೆ? ವೆಕ್ಟರ್ ಡಾಟಾಬೇಸ್ಗಳು.
ಮೂರು ವರ್ಷಗಳ ಹಿಂದೆ, ವೆಕ್ಟರ್ ಡಾಟಾಬೇಸ್ಗಳು ಒಂದು ನಿರ್ದಿಷ್ಟ ಕ್ಷೇತ್ರದ ತಂತ್ರಜ್ಞಾನವಾಗಿದ್ದವು. ಇಂದು, ಅವು ಅಡಿಪಾಯವಾಗಿವೆ. AI ಬಗ್ಗೆ ಗಂಭೀರವಾಗಿರುವ ಪ್ರತಿಯೊಂದು ಸಂಸ್ಥೆಯೂ—ನೀವು ಗ್ರಾಹಕ ಬೆಂಬಲ ಚಾಟ್ಬಾಟ್ ಅನ್ನು ನಿರ್ಮಿಸುತ್ತಿರಲಿ ಅಥವಾ ವಂಚನೆ ಪತ್ತೆ ವ್ಯವಸ್ಥೆಯನ್ನು ನಿರ್ಮಿಸುತ್ತಿರಲಿ—ಈಗ ಒಂದೇ ಪ್ರಶ್ನೆಯೊಂದಿಗೆ ಹೆಣಗಾಡುತ್ತಿದೆ: "AI ನಿಜವಾಗಿಯೂ ನಮ್ಮ ವ್ಯವಹಾರವನ್ನು ಅರ್ಥಮಾಡಿಕೊಳ್ಳುವಂತೆ ಮಾಡುವುದು ಹೇಗೆ?"
ಇದಕ್ಕೆ ಉತ್ತರವೇ ವೆಕ್ಟರ್ ಡಾಟಾಬೇಸ್ಗಳು.
ಭಾಗ 1: ವೆಕ್ಟರ್ ಎಂಬೆಡಿಂಗ್ ಎಂದರೆ ನಿಜವಾಗಿಯೂ ಏನು?
ಒಂದು ಮೂಲಭೂತ ಸಮಸ್ಯೆಯಿಂದ ಪ್ರಾರಂಭಿಸೋಣ: ಕಂಪ್ಯೂಟರ್ಗಳಿಗೆ ಅರ್ಥವಾಗುವುದಿಲ್ಲ.
ಸಾಂಪ್ರದಾಯಿಕ ಡಾಟಾಬೇಸ್ "king" ಎಂಬ ಪದವನ್ನು ನೋಡಿದಾಗ, ಅದು ಅದನ್ನು ಪಠ್ಯದ ಸ್ಟ್ರಿಂಗ್ ಆಗಿ ನೋಡುತ್ತದೆ. ಮೆಷಿನ್ ಲರ್ನಿಂಗ್ ಮಾಡೆಲ್ "king" ಅನ್ನು ನೋಡಿದಾಗ, ಅದು ಅದನ್ನು ಸಂಪೂರ್ಣವಾಗಿ ಭಿನ್ನವಾದ ವಿಷಯವಾಗಿ ಮಾರ್ಪಡಿಸುತ್ತದೆ: ನೂರಾರು ಅಥವಾ ಸಾವಿರಾರು ಸಂಖ್ಯೆಗಳ ಪಟ್ಟಿ, ಪ್ರತಿಯೊಂದೂ ಅದೃಶ್ಯ, ಉನ್ನತ-ಯಾಮದ ಜಾಗದಲ್ಲಿ ಒಂದು ನಿರ್ದೇಶಾಂಕವನ್ನು ಪ್ರತಿನಿಧಿಸುತ್ತದೆ.
ಇದೇ ವೆಕ್ಟರ್ ಎಂಬೆಡಿಂಗ್.
ಇವುಗಳನ್ನು ಅದ್ಭುತವಾಗಿಸುವುದು ಇಲ್ಲಿದೆ:
ಈ ಸಾಂಖ್ಯಿಕ ಜಾಗದಲ್ಲಿ, ಒಂದೇ ರೀತಿಯ ಅರ್ಥಗಳು ಸ್ವಯಂಚಾಲಿತವಾಗಿ ಒಂದೆಡೆ ಸೇರುತ್ತವೆ. "king" ಗಾಗಿ ಎಂಬೆಡಿಂಗ್ ಗಣಿತೀಯವಾಗಿ "queen", "royalty", "monarch", ಮತ್ತು "throne" ಗೆ ಹತ್ತಿರದಲ್ಲಿ ಕುಳಿತುಕೊಳ್ಳುತ್ತದೆ. ಯಾರೂ ಈ ಸಂಬಂಧವನ್ನು ಸ್ಪಷ್ಟವಾಗಿ ಪ್ರೋಗ್ರಾಮ್ ಮಾಡಿದ್ದಕ್ಕಾಗಿ ಅಲ್ಲ, ಆದರೆ AI ಮಾಡೆಲ್ ಮಾನವ ಭಾಷೆಯ ಮಾದರಿಗಳಿಂದ ಈ ಸಂಪರ್ಕಗಳನ್ನು ಕಲಿತಿದ್ದಕ್ಕಾಗಿ.
ಇದು ಸಾಂಪ್ರದಾಯಿಕ ಹುಡುಕಾಟಕ್ಕಿಂತ ಮೂಲಭೂತವಾಗಿ ಭಿನ್ನವಾಗಿದೆ. ಸಾಂಪ್ರದಾಯಿಕ ಡಾಟಾಬೇಸ್ "king" ಎಂಬ ನಿಖರವಾದ ಪಠ್ಯಕ್ಕಾಗಿ ಹುಡುಕುತ್ತದೆ ಮತ್ತು "king" ಅನ್ನು ಮಾತ್ರ ಕಂಡುಕೊಳ್ಳುತ್ತದೆ. ವೆಕ್ಟರ್ ಡಾಟಾಬೇಸ್ "king" ನ ಅರ್ಥಕ್ಕಾಗಿ ಹುಡುಕುತ್ತದೆ ಮತ್ತು ನಿಖರವಾದ ಹೊಂದಾಣಿಕೆಗಳಿಲ್ಲದೆ ಸಂಬಂಧಿತ ಪರಿಕಲ್ಪನೆಗಳನ್ನು ಕಂಡುಕೊಳ್ಳುತ್ತದೆ.
ಸಾಂಪ್ರದಾಯಿಕ ಹುಡುಕಾಟ ವರ್ಸಸ್ ಸೆಮ್ಯಾಂಟಿಕ್ ಹುಡುಕಾಟ: ಒಂದು ನೈಜ-ಪ್ರಪಂಚದ ಉದಾಹರಣೆ
ಇ-ಕಾಮರ್ಸ್ ಪ್ಲಾಟ್ಫಾರ್ಮ್ಗಾಗಿ ನೀವು ಗ್ರಾಹಕರ ಬೆಂಬಲ ವ್ಯವಸ್ಥೆಯನ್ನು ನಿರ್ಮಿಸುತ್ತಿದ್ದೀರಿ ಎಂದು ಕಲ್ಪಿಸಿಕೊಳ್ಳಿ. ಬಳಕೆದಾರರೊಬ್ಬರು ಸಂದೇಶ ಕಳುಹಿಸುತ್ತಾರೆ:
"ನಿಮ್ಮ ಶಿಪ್ಪಿಂಗ್ ತುಂಬಾ ನಿಧಾನವಾಗಿದೆ. ನನ್ನ ವಸ್ತುವನ್ನು ಪಡೆಯಲು ತುಂಬಾ ಸಮಯ ತೆಗೆದುಕೊಂಡಿತು."
ಸಾಂಪ್ರದಾಯಿಕ ಕೀವರ್ಡ್ ಹುಡುಕಾಟ: "shipping", "slow", "delivery" ನಂತಹ ನಿಖರವಾದ ಹೊಂದಾಣಿಕೆಗಳನ್ನು ಹುಡುಕುತ್ತದೆ. ಸರಿ ಎನಿಸುವಂತೆ ಕೆಲಸ ಮಾಡುತ್ತದೆ, ಆದರೆ "logistics" ಅಥವಾ "package speed" ಕುರಿತಾದ ಟಿಕೆಟ್ಗಳನ್ನು ತಪ್ಪಿಸಿಕೊಳ್ಳಬಹುದು.
ವೆಕ್ಟರ್ ಡಾಟಾಬೇಸ್ ಸೆಮ್ಯಾಂಟಿಕ್ ಹುಡುಕಾಟ: ನಿಖರವಾದ ಪದಗಳು ಬದಲಾಗಿದ್ದರೂ ಸಹ, ಈ ದೂರು ಮೂಲಭೂತವಾಗಿ ಡೆಲಿವರಿ ಸಮಯದ ಕಾರ್ಯಕ್ಷಮತೆಯ ಬಗ್ಗೆಯಾಗಿದೆ ಎಂದು ಅರ್ಥಮಾಡಿಕೊಳ್ಳುತ್ತದೆ. ಇದು ಸ್ವಯಂಚಾಲಿತವಾಗಿ "packages taking ages" ಅಥವಾ "getting orders faster than I expected" ಕುರಿತಾದ ವೈವಿಧ್ಯಮಯ ದೂರುಗಳನ್ನು ಕಂಡುಕೊಳ್ಳುತ್ತದೆ. ಸಿಸ್ಟಮ್ ವಿವಿಧ ಬದಲಾವಣೆಗಳಾದ್ಯಂತ ಗ್ರಾಹಕರ ಭಾವನೆಯನ್ನು ಕಲಿಯುತ್ತದೆ.
ಇದೇ ಎಂಬೆಡಿಂಗ್ಗಳ ಶಕ್ತಿ.
ಭಾಗ 2: ವೆಕ್ಟರ್ ಡಾಟಾಬೇಸ್ಗಳು ನಿಜವಾಗಿ ಹೇಗೆ ಕೆಲಸ ಮಾಡುತ್ತವೆ (ಹಂತ ಹಂತವಾಗಿ)
ಇದರ ಆರ್ಕಿಟೆಕ್ಚರ್ ಅತ್ಯಂತ ಸುಂದರವಾಗಿದೆ:
ಹಂತ 1: ನಿಮ್ಮ ಡೇಟಾವನ್ನು ವೆಕ್ಟರ್ಗಳಾಗಿ ಪರಿವರ್ತಿಸಿ
ನಿಮ್ಮ ಕಚ್ಚಾ ಡೇಟಾ—ಒಂದು ದಾಖಲೆ, ಒಂದು ಚಿತ್ರ, ಉತ್ಪನ್ನದ ವಿವರಣೆ, ಗ್ರಾಹಕರ ಪರಸ್ಪರ ಕ್ರಿಯೆಯ ಲಾಗ್—ಎಂಬೆಡಿಂಗ್ ಮಾಡೆಲ್ ಮೂಲಕ ರವಾನೆಯಾಗುತ್ತದೆ (ಇದನ್ನು ಗಣಿತದ ಅನುವಾದಕ ಎಂದು ಭಾವಿಸಿ).
ಈ ಮಾಡೆಲ್ಗಳನ್ನು ಬೃಹತ್ ಪ್ರಮಾಣದ ಮಾನವ ಜ್ಞಾನದ ಮೇಲೆ ಪೂರ್ವ ತರಬೇತಿ ನೀಡಲಾಗಿರುತ್ತದೆ. OpenAI ನ ಎಂಬೆಡಿಂಗ್ ಮಾಡೆಲ್ಗಳು, HuggingFace ಮಾಡೆಲ್ಗಳು, ಅಥವಾ ಕಸ್ಟಮ್ ತರಬೇತಿ ಪಡೆದ ಮಾಡೆಲ್ಗಳು ಅರ್ಥವನ್ನು ನಿರ್ದೇಶಾಂಕಗಳಾಗಿ ಪ್ರತಿನಿಧಿಸಲು ಕಲಿಯುತ್ತವೆ.
ಒಂದು ಪಠ್ಯದ ಭಾಗವು ಒಂದು ವೆಕ್ಟರ್ ಆಗುತ್ತದೆ. ವೆಕ್ಟರ್ ಎಂಬುದು ಸಂಖ್ಯೆಗಳ ಪಟ್ಟಿಯಾಗಿದೆ. ಎಂಬೆಡಿಂಗ್ ಆಯಾಮವು 1536 ಆಗಿದ್ದರೆ (ಆಧುನಿಕ ಮಾಡೆಲ್ಗಳಿಗೆ ಸಾಮಾನ್ಯವಾಗಿದೆ), ಆ ಪಠ್ಯ ವಿಷಯವನ್ನು ಪ್ರತಿನಿಧಿಸುವ 1536 ಸಂಖ್ಯೆಗಳು ನಿಮಗೆ ಸಿಗುತ್ತವೆ.
ಹಂತ 2: ವೆಕ್ಟರ್ ಡಾಟಾಬೇಸ್ನಲ್ಲಿ ಸಂಗ್ರಹಿಸಿ
ನಿಖರವಾದ ಹೊಂದಾಣಿಕೆಗಳು ಮತ್ತು ತ್ವರಿತ ಸಾಲಿನ ಮರುಪಡೆಯುವಿಕೆಗಾಗಿ ಹೊಂದುವಂತೆ ಮಾಡುವ ಸಾಂಪ್ರದಾಯಿಕ ಡಾಟಾಬೇಸ್ಗಳಿಗಿಂತ ಭಿನ್ನವಾಗಿ, ವೆಕ್ಟರ್ ಡಾಟಾಬೇಸ್ಗಳನ್ನು ಸಂಪೂರ್ಣವಾಗಿ ಭಿನ್ನವಾದ ವಿಷಯಕ್ಕಾಗಿ ನಿರ್ಮಿಸಲಾಗಿದೆ: ಕ್ವೆರಿ ವೆಕ್ಟರ್ಗೆ ಹತ್ತಿರದ ಗಣಿತದ ನೆರೆಹೊರೆಯವರನ್ನು ಕಂಡುಹಿಡಿಯುವುದು.
ಡಾಟಾಬೇಸ್ಗಳು ವಿಶೇಷವಾದ ಸೂಚ್ಯಂಕ ರಚನೆಗಳನ್ನು ಬಳಸುತ್ತವೆ—ಮುಖ್ಯವಾಗಿ Approximate Nearest Neighbor (ANN) ಆಲ್ಗರಿದಮ್ಗಳಾದ:
-
HNSW (Hierarchical Navigable Small World): ನೈಜ-ಪ್ರಪಂಚದ ನ್ಯಾವಿಗೇಷನ್ ಸಿಸ್ಟಮ್ಗಳಿಂದ ಪ್ರೇರಿತವಾಗಿದೆ
-
IVF (Inverted File Index): ಒಂದೇ ರೀತಿಯ ವೆಕ್ಟರ್ಗಳನ್ನು ಕ್ಲಸ್ಟರ್ಗಳಾಗಿ ಗುಂಪು ಮಾಡುತ್ತದೆ
-
IVFAGG (Quantization): ಬೃಹತ್ ಡೇಟಾಸೆಟ್ಗಳಲ್ಲಿ ವೇಗಕ್ಕಾಗಿ ನಿಖರತೆಯನ್ನು ಸರಿಹೊಂದಿಸುತ್ತದೆ
ಈ ಸೂಚ್ಯಂಕಗಳು ಸಂಗ್ರಹಿಸಿದ ಪ್ರತಿಯೊಂದು ವೆಕ್ಟರ್ಗೆ ನಿಮ್ಮ ಕ್ವೆರಿ ವೆಕ್ಟರ್ ಅನ್ನು ಹೋಲಿಸುವ ಕಂಪ್ಯೂಟೇಷನಲ್ ಕಷ್ಟವನ್ನು ತಪ್ಪಿಸಲು ಸಿಸ್ಟಮ್ಗೆ ಅವಕಾಶ ನೀಡುತ್ತವೆ. ಬದಲಾಗಿ, ಇದು ಹುಡುಕಾಟದ ಜಾಗವನ್ನು ಜಾಣತನದಿಂದ ಕಿರಿದಾಗಿಸುತ್ತದೆ.
ಹಂತ 3: ಸಾಮೀಪ್ಯದಿಂದ ಹುಡುಕಿ, ನಿಖರವಾದ ಹೊಂದಾಣಿಕೆಯಿಂದಲ್ಲ
ನೀವು ಹುಡುಕಿದಾಗ, ಅದೇ ಎಂಬೆಡಿಂಗ್ ಮಾಡೆಲ್ ಅನ್ನು ಬಳಸಿ ನಿಮ್ಮ ಕ್ವೆರಿಯು ವೆಕ್ಟರ್ ಆಗುತ್ತದೆ. ನಂತರ ಡಾಟಾಬೇಸ್ ನಿಮ್ಮ ಕ್ವೆರಿ ವೆಕ್ಟರ್ ಮತ್ತು ಪ್ರತಿ ಇಂಡೆಕ್ಸ್ ಮಾಡಿದ ವೆಕ್ಟರ್ ನಡುವಿನ ಗಣಿತದ ದೂರವನ್ನು ಲೆಕ್ಕಾಚಾರ ಮಾಡುತ್ತದೆ. ಸಾಮಾನ್ಯ ದೂರದ ಮೆಟ್ರಿಕ್ಗಳು ಸೇರಿವೆ:
-
Cosine Similarity: ವೆಕ್ಟರ್ಗಳ ನಡುವಿನ ಕೋನವನ್ನು ಅಳೆಯುತ್ತದೆ (0 ರಿಂದ 1 ಸ್ಕೇಲ್)
-
Euclidean Distance: ಉನ್ನತ-ಯಾಮದ ಜಾಗದಲ್ಲಿ ನೇರ-ರೇಖೆಯ ದೂರವನ್ನು ಅಳೆಯುತ್ತದೆ
-
Manhattan Distance: ನಿರಪೇಕ್ಷ ವ್ಯತ್ಯಾಸಗಳ ಮೊತ್ತ
ಡಾಟಾಬೇಸ್ ಹತ್ತಿರದ ನೆರೆಹೊರೆಯವರನ್ನು ಹಿಂತಿರುಗಿಸುತ್ತದೆ—ನಿಮ್ಮ ಕ್ವೆರಿಗೆ ಅತ್ಯಂತ ಸಮಾನವಾದ ವೆಕ್ಟರ್ಗಳು.
ಭಾಗ 3: ವೆಕ್ಟರ್ ಡಾಟಾಬೇಸ್ಗಳು ವರ್ಸಸ್ ಸಾಂಪ್ರದಾಯಿಕ ಡಾಟಾಬೇಸ್ಗಳು
ಸ್ಪಷ್ಟವಾಗಿ ಹೇಳಬೇಕೆಂದರೆ: ವೆಕ್ಟರ್ ಡಾಟಾಬೇಸ್ಗಳು ಸಾಂಪ್ರದಾಯಿಕ ಡಾಟಾಬೇಸ್ಗಳನ್ನು ಬದಲಾಯಿಸುವುದಿಲ್ಲ. ಅವು ಅವುಗಳಿಗೆ ಪೂರಕವಾಗಿವೆ.
| ಅಂಶ | ಸಾಂಪ್ರದಾಯಿಕ ಡಾಟಾಬೇಸ್ (SQL/NoSQL) | ವೆಕ್ಟರ್ ಡಾಟಾಬೇಸ್ |
|---|---|---|
| ಡೇಟಾ ಪ್ರಕಾರ | ರಚನಾತ್ಮಕ: ಪಠ್ಯ, ಸಂಖ್ಯೆಗಳು, ದಿನಾಂಕಗಳು, JSON | ಉನ್ನತ-ಯಾಮದ ಎಂಬೆಡಿಂಗ್ಗಳು (ಸಾಮಾನ್ಯವಾಗಿ 768-3072 ಆಯಾಮಗಳು) |
| ಕ್ವೆರಿ ಪ್ಯಾಟರ್ನ್ | ನಿಖರವಾದ ಹೊಂದಾಣಿಕೆ: WHERE status = 'active' | ಸಾಮೀಪ್ಯ: "ಈ ಕ್ವೆರಿಗೆ 10 ಅತ್ಯಂತ ಹತ್ತಿರದ ಅರ್ಥಗಳನ್ನು ಹುಡುಕಿ" |
| ಪ್ರಾಥಮಿಕ ಶಕ್ತಿ | ACID ಅನುಸರಣೆ, ವಹಿವಾಟಿನ ಸ್ಥಿರತೆ | ದೊಡ್ಡ ಪ್ರಮಾಣದಲ್ಲಿ ವೇಗದ ಗಣಿತದ ದೂರದ ಲೆಕ್ಕಾಚಾರಗಳು |
| ಇಂಡೆಕ್ಸ್ ರಚನೆ | B-tree, ಹ್ಯಾಶ್ ಇಂಡೆಕ್ಸ್ಗಳು | HNSW, IVF, Product Quantization |
| ಬಳಕೆಯ ಸಂದರ್ಭ | ದಾಸ್ತಾನು, ಬಳಕೆದಾರರ ಖಾತೆಗಳು, ಬಿಲ್ಲಿಂಗ್ | AI-ಚಾಲಿತ ಹುಡುಕಾಟ, RAG, ಶಿಫಾರಸುಗಳು |
| ಕ್ವೆರಿ ವೇಗ | ನಿಖರವಾದ ಹೊಂದಾಣಿಕೆಗಳಿಗಾಗಿ ಮಿಲಿಸೆಕೆಂಡ್ಗಳು | ಮಿಲಿಯನ್ಗಟ್ಟಲೆ ವೆಕ್ಟರ್ಗಳಲ್ಲಿ ಸಾಮೀಪ್ಯಕ್ಕಾಗಿ ಮಿಲಿಸೆಕೆಂಡ್ಗಳು |
ಉತ್ಪಾದನಾ ವ್ಯವಸ್ಥೆಗಳಲ್ಲಿ, ನೀವು ಸಾಮಾನ್ಯವಾಗಿ ಎರಡನ್ನೂ ಬಳಸುತ್ತೀರಿ. ನಿಮ್ಮ ಬಳಕೆದಾರರ ಪ್ರೊಫೈಲ್ PostgreSQL ನಲ್ಲ ಇರುತ್ತದೆ. ಗ್ರಾಹಕರ ಬೆಂಬಲ ಟಿಕೆಟ್ಗಳ ಸೆಮ್ಯಾಂಟಿಕ್ ಅರ್ಥೈಸಿಕೊಳ್ಳುವಿಕೆಯು ವೆಕ್ಟರ್ ಡಾಟಾಬೇಸ್ನಲ್ಲಿರುತ್ತದೆ.
ಭಾಗ 4: 2024-2026 ರಲ್ಲಿ ವೆಕ್ಟರ್ ಡಾಟಾಬೇಸ್ಗಳು ಏಕೆ ಪ್ರಚಂಡವಾಗಿ ಬೆಳೆದವು
ಮೂರು ಒಗ್ಗೂಡುವ ಪ್ರವೃತ್ತಿಗಳು ಪರಿಪೂರ್ಣ ವಾತಾವರಣವನ್ನು ಸೃಷ್ಟಿಸಿದವು:
1. ಲಾರ್ಜ್ ಲ್ಯಾಂಗ್ವೇಜ್ ಮಾಡೆಲ್ಗಳು (LLMs) ನೈಜ ಮಿತಿಗಳನ್ನು ಹೊಂದಿವೆ
2026 ರ ವೇಳೆಗೆ, LLM ಗಳು ಶಕ್ತಿಶಾಲಿ ಆದರೆ ಪರಿಪೂರ್ಣವಲ್ಲ ಎಂದು ಎಲ್ಲರಿಗೂ ತಿಳಿದಿದೆ. ಅವುಗಳು:
-
ಜ್ಞಾನದ ಕಟ್ಆಫ್ ಹೊಂದಿವೆ (ಅವುಗಳಿಗೆ ಇತ್ತೀಚಿನ ಘಟನೆಗಳ ಬಗ್ಗೆ ತಿಳಿದಿರುವುದಿಲ್ಲ)
-
ಭ್ರಮೆಗೆ ಒಳಗಾಗಬಹುದು (ತಪ್ಪು ಮಾಹಿತಿಯನ್ನು ಆತ್ಮವಿಶ್ವಾಸದಿಂದ ಹೇಳಬಹುದು)
-
ಮಾಲೀಕತ್ವದ ಆಂತರಿಕ ಡೇಟಾಗೆ ಪ್ರವೇಶವನ್ನು ಹೊಂದಿರುವುದಿಲ್ಲ
-
ಉದಾಹರಣೆಗಳಿಲ್ಲದೆ ಹೊಸ ಸಮಸ್ಯೆಗಳನ್ನು ವಿಶ್ಲೇಷಿಸಲು ಸಾಧ್ಯವಿಲ್ಲ
2. Retrieval-Augmented Generation (RAG) ಅತ್ಯಗತ್ಯವಾಯಿತು
ಪರಿಹಾರವು ಹೊರಹೊಮ್ಮಿತು: LLM ಅನ್ನು ವೆಕ್ಟರ್ ಡಾಟಾಬೇಸ್ನೊಂದಿಗೆ ಜೋಡಿಸಿ.
2026 ರಲ್ಲಿ ಎಂಟರ್ಪ್ರೈಸ್ ಚಾಟ್ಬಾಟ್ಗಾಗಿ ಕೆಲಸದ ಹರಿವು:
- ಸಂಸ್ಥೆಯು 10,000 ಆಂತರಿಕ ದಾಖಲೆಗಳನ್ನು ಅಪ್ಲೋಡ್ ಮಾಡುತ್ತದೆ (ನೀತಿಗಳು, ಮಾರ್ಗದರ್ಶಿಗಳು, ಕೋಡ್ ದಾಖಲೆಗಳು)
- ಪ್ರತಿಯೊಂದು ದಾಖಲೆಯು ಚಂಕ್ಗಳಾಗಿ ವಿಂಗಡಿಸಲ್ಪಡುತ್ತದೆ ಮತ್ತು ವೆಕ್ಟರ್ಗಳಾಗಿ ಪರಿವರ್ತಿತವಾಗುತ್ತದೆ
- ಬಳಕೆದಾರರು ಚಾಟ್ಬಾಟ್ಗೆ ಪ್ರಶ್ನೆಯನ್ನು ಕೇಳುತ್ತಾರೆ
- ಅವರ ಪ್ರಶ್ನೆಯು ಒಂದು ವೆಕ್ಟರ್ ಆಗುತ್ತದೆ
- ವೆಕ್ಟರ್ ಡಾಟಾಬೇಸ್ 5-10 ಅತ್ಯಂತ ಸೂಕ್ತವಾದ ದಾಖಲೆಯ ಚಂಕ್ಗಳನ್ನು ಕಂಡುಹಿಡಿಯುತ್ತದೆ
- ಈ ಚಂಕ್ಗಳನ್ನು ಸಂದರ್ಭವಾಗಿ LLM ಗೆ ನೀಡಲಾಗುತ್ತದೆ
- LLM ಸಂಸ್ಥೆಗೆ ನಿರ್ದಿಷ್ಟವಾದ ಮಾಹಿತಿಯ ಆಧಾರದ ಮೇಲೆ ಉತ್ತರವನ್ನು ರಚಿಸುತ್ತದೆ
ಇದು ಭ್ರಮೆಯ ಸಮಸ್ಯೆಯನ್ನು ಪರಿಹರಿಸಿದೆ. ನಿಮ್ಮ ವೆಕ್ಟರ್ ಡಾಟಾಬೇಸ್ನಿಂದ ವಾಸ್ತವಿಕ ಡೇಟಾದಲ್ಲಿ LLM ಅನ್ನು ಆಧಾರವಾಗಿರಿಸುವುದರಿಂದ, ನೀವು ನಿಖರವಾದ, ವ್ಯವಹಾರ-ನಿರ್ದಿಷ್ಟ ಉತ್ತರಗಳನ್ನು ಪಡೆಯುತ್ತೀರಿ.
3. AI ಸಂಶೋಧನೆಯಿಂದ ಉತ್ಪಾದನೆಗೆ ಸ್ಥಳಾಂತರಗೊಂಡಿತು
2023-2024 ರಲ್ಲಿ, AI ನವೀನವಾಗಿತ್ತು. 2026 ರ ವೇಳೆಗೆ, ಇದು ಕಾರ್ಯಾಚರಣೆಯ ಮೂಲಸೌಕರ್ಯವಾಗಿದೆ. ಪ್ರತಿಯೊಂದು ಸ್ಟಾರ್ಟ್ಅಪ್ ಮತ್ತು ಸಂಸ್ಥೆಯು ಕನಿಷ್ಠ ಒಂದು AI ಸಿಸ್ಟಮ್ ಅನ್ನು ನಿಯೋಜಿಸಿದೆ:
-
ಶಿಫಾರಸು ಎಂಜಿನ್ಗಳು
-
ಸೆಮ್ಯಾಂಟಿಕ್ ಹುಡುಕಾಟ
-
ಅಸಂಗತತೆ ಪತ್ತೆ
-
ವಿಷಯ ಮಾಡರೇಶನ್
-
ಸಾಮೀಪ್ಯ ವಿಶ್ಲೇಷಣೆ
ಮತ್ತು ಇವುಗಳಲ್ಲಿ ಪ್ರತಿಯೊಂದಕ್ಕೂ ವೆಕ್ಟರ್ ಡಾಟಾಬೇಸ್ ಅಗತ್ಯವಿದೆ.
ಭಾಗ 5: 2026 ರಲ್ಲಿ ನೈಜ-ಪ್ರಪಂಚದ ಬಳಕೆಯ ಸಂದರ್ಭಗಳು
ಬಳಕೆಯ ಸಂದರ್ಭ 1: ಇ-ಕಾಮರ್ಸ್ ಶಿಫಾರಸು ಎಂಜಿನ್
ಸನ್ನಿವೇಶ: TechStash Inc., 50,000 ಉತ್ಪನ್ನಗಳನ್ನು ಹೊಂದಿರುವ ಮಧ್ಯಮ ಮಾರುಕಟ್ಟೆಯ ಎಲೆಕ್ಟ್ರಾನಿಕ್ಸ್ ಚಿಲ್ಲರೆ ಮಾರಾಟಗಾರ
ಸಮಸ್ಯೆ: ಸಾಂಪ್ರದಾಯಿಕ ಶಿಫಾರಸುಗಳು (X ಅನ್ನು ಖರೀದಿಸಿದ ಬಳಕೆದಾರರು Y ಅನ್ನು ಸಹ ಖರೀದಿಸಿದ್ದಾರೆ) ಕೆಲಸ ಮಾಡುತ್ತವೆ ಆದರೆ ಸೆಮ್ಯಾಂಟಿಕ್ ಸಂಪರ್ಕಗಳನ್ನು ತಪ್ಪಿಸಿಕೊಳ್ಳುತ್ತವೆ. "fast laptops for programming" ನಲ್ಲಿ ಆಸಕ್ತಿ ಹೊಂದಿರುವ ಬಳಕೆದಾರರು ಉದ್ದೇಶದ ಆಧಾರದ ಮೇಲಲ್ಲದೆ, ನಿಖರವಾದ ಖರೀದಿ ಇತಿಹಾಸದ ಆಧಾರದ ಮೇಲೆ ಶಿಫಾರಸುಗಳನ್ನು ಪಡೆಯುತ್ತಾರೆ.
ವೆಕ್ಟರ್ ಡಾಟಾಬೇಸ್ನೊಂದಿಗೆ ಪರಿಹಾರ:
- ಉತ್ಪನ್ನದ ವಿವರಣೆಗಳು, ಗ್ರಾಹಕರ ವಿಮರ್ಶೆಗಳು ಮತ್ತು ತಾಂತ್ರಿಕ ವಿವರಣೆಗಳು ವೆಕ್ಟರೈಸ್ ಆಗುತ್ತವೆ
- ಗ್ರಾಹಕರ ಬ್ರೌಸಿಂಗ್ ಇತಿಹಾಸ ಮತ್ತು ಖರೀದಿ ನಡವಳಿಕೆಯು ವೆಕ್ಟರೈಸ್ ಆಗುತ್ತದೆ
- ಗ್ರಾಹಕರು ಲ್ಯಾಪ್ಟಾಪ್ ಅನ್ನು ವೀಕ್ಷಿಸಿದಾಗ, ಸಿಸ್ಟಮ್ ವೆಕ್ಟರ್ ಸಾಮೀಪ್ಯವನ್ನು ಬಳಸಿ ಸಮಾನ ಉತ್ಪನ್ನಗಳನ್ನು ಕಂಡುಕೊಳ್ಳುತ್ತದೆ
- ಶಿಫಾರಸುಗಳು ಈಗ "lightweight", "high-performance", "good battery life" ನ ಸೆಮ್ಯಾಂಟಿಕ್ ಅರ್ಥವನ್ನು ಅರ್ಥಮಾಡಿಕೊಳ್ಳುತ್ತವೆ
- ಫಲಿತಾಂಶ: ಶಿಫಾರಸು ಕ್ಲಿಕ್-ಥ್ರೂ ದರದಲ್ಲಿ 34% ಹೆಚ್ಚಳ (ವಾಸ್ತವಿಕ 2026 ಬೆಂಚ್ಮಾರ್ಕ್)
ಬಳಕೆಯ ಸಂದರ್ಭ 2: ಗ್ರಾಹಕ ಬೆಂಬಲ ಸ್ವಯಂಚಾಲನೆ
ಸನ್ನಿವೇಶ: CloudIntel Solutions, ಪ್ರತಿದಿನ 500+ ಗ್ರಾಹಕ ಬೆಂಬಲ ಟಿಕೆಟ್ಗಳನ್ನು ಹೊಂದಿರುವ SaaS ಪ್ಲಾಟ್ಫಾರ್ಮ್
ಸಮಸ್ಯೆ: ಟಿಕೆಟ್ಗಳನ್ನು ಹಸ್ತಚಾಲಿತವಾಗಿ ವರ್ಗೀಕರಿಸುವುದು ನಿಧಾನವಾಗಿದೆ. ಗ್ರಾಹಕರು ವಿಭಿನ್ನ ಪರಿಭಾಷೆಯನ್ನು ಬಳಸಿದಾಗ ಕೀವರ್ಡ್-ಆಧಾರಿತ ರೂಟಿಂಗ್ ನಿಯಮಗಳನ್ನು ನಿರ್ಮಿಸುವುದು ವಿಫಲಗೊಳ್ಳುತ್ತದೆ.
ವೆಕ್ಟರ್ ಡಾಟಾಬೇಸ್ನೊಂದಿಗೆ ಪರಿಹಾರ:
- ಹಳೆಯ ಟಿಕೆಟ್ಗಳನ್ನು (ಬೆಂಬಲ ತಂಡದಿಂದ ವರ್ಗೀಕರಿಸಲ್ಪಟ್ಟ) ವೆಕ್ಟರೈಸ್ ಮಾಡಲಾಗುತ್ತದೆ
- ಬರುವ ಟಿಕೆಟ್ಗಳು ನೈಜ-ಸಮಯದಲ್ಲಿ ವೆಕ್ಟರೈಸ್ ಆಗುತ್ತವೆ
- ವೆಕ್ಟರ್ ಡಾಟಾಬೇಸ್ ಅತ್ಯಂತ ಸಮಾನವಾದ 5 ಹಳೆಯ ಟಿಕೆಟ್ಗಳನ್ನು ಕಂಡುಕೊಳ್ಳುತ್ತದೆ
- ಸಿಸ್ಟಮ್ 91% ನಿಖರತೆಯೊಂದಿಗೆ ಸೂಕ್ತವಾದ ತಂಡಕ್ಕೆ ರೂಟ್ ಮಾಡುತ್ತದೆ
- ಸಂಕೀರ್ಣವಾದ ಪ್ರಕರಣಗಳನ್ನು ಮಾನವ ಪರಿಶೀಲನೆಗಾಗಿ ಫ್ಲ್ಯಾಗ್ ಮಾಡಲಾಗುತ್ತದೆ
2026 ರ ಪ್ರಯೋಜನ: ಮೊದಲ-ಪ್ರತಿಕ್ರಿಯೆಯ ಸಮಯವನ್ನು 6 ಗಂಟೆಗಳಿಂದ 12 ನಿಮಿಷಗಳಿಗೆ ಕಡಿತಗೊಳಿಸಲಾಗಿದೆ. ಬೆಂಬಲ ತಂಡವು ವರ್ಗೀಕರಣದ ಬದಲಿಗೆ ಸಂಕೀರ್ಣ ಸಮಸ್ಯೆಗಳ ಮೇಲೆ ಗಮನಹರಿಸುತ್ತದೆ.
ಬಳಕೆಯ ಸಂದರ್ಭ 3: ಭದ್ರತೆ & ಅಸಂಗತತೆ ಪತ್ತೆ
ಸನ್ನಿವೇಶ: DefenseNet Inc., ಒಂದು ಎಂಟರ್ಪ್ರೈಸ್ ಸೈಬರ್ ಸೆಕ್ಯುರಿಟಿ ಪ್ಲಾಟ್ಫಾರ್ಮ್
ಸಮಸ್ಯೆ: ನೆಟ್ವರ್ಕ್ ಲಾಗ್ಗಳು ಮಿಲಿಯನ್ಗಟ್ಟಲೆ ಈವೆಂಟ್ಗಳನ್ನು ಹೊಂದಿರುತ್ತವೆ. ಹೆಚ್ಚಿನವು ಸಾಮಾನ್ಯವಾಗಿವೆ. ನೈಜ ಬೆದರಿಕೆಗಳನ್ನು ಕಂಡುಹಿಡಿಯುವುದು ಹುಲ್ಲಿನ ಹೊದೆಯಲ್ಲಿ ಸೂಜಿಯನ್ನು ಹುಡುಕಿದಂತೆ.
ವೆಕ್ಟರ್ ಡಾಟಾಬೇಸ್ನೊಂದಿಗೆ ಪರಿಹಾರ:
- ಹಳೆಯ ನೆಟ್ವರ್ಕ್ ಲಾಗ್ಗಳನ್ನು (ಸಾಮಾನ್ಯ ಅಥವಾ ಬೆದರಿಕೆ ಎಂದು ಲೇಬಲ್ ಮಾಡಲಾದ) ವೆಕ್ಟರೈಸ್ ಮಾಡಲಾಗುತ್ತದೆ
- ಸಾಮಾನ್ಯ ನಡವಳಿಕೆಯು ವೆಕ್ಟರ್ ಜಾಗದಲ್ಲಿ ಒಂದು ಕ್ಲಸ್ಟರ್ ಅನ್ನು ಸೃಷ್ಟಿಸುತ್ತದೆ
- ನೈಜ-ಸಮಯದ ಈವೆಂಟ್ಗಳು ವೆಕ್ಟರೈಸ್ ಆಗುತ್ತವೆ ಮತ್ತು ಸಾಮಾನ್ಯ ಕ್ಲಸ್ಟರ್ಗೆ ಹೋಲಿಸಲ್ಪಡುತ್ತವೆ
- ಸಾಮಾನ್ಯ ಕ್ಲಸ್ಟರ್ನಿಂದ ದೂರವಿರುವ ವೆಕ್ಟರ್ಗಳನ್ನು ಸಂಭಾವ್ಯ ಬೆದರಿಕೆಗಳಾಗಿ ಫ್ಲ್ಯಾಗ್ ಮಾಡಲಾಗುತ್ತದೆ
- ನಿಯಮ-ಆಧಾರಿತ ಸಿಸ್ಟಮ್ಗಳಿಗೆ ಹೋಲಿಸಿದರೆ ತಪ್ಪು ಧನಾತ್ಮಕಗಳನ್ನು ಗಣನೀಯವಾಗಿ ಕಡಿತಗೊಳಿಸುತ್ತದೆ
2026 ರ ವಾಸ್ತವ: ಇದು ಈಗಾಗಲೇ ಎಂಟರ್ಪ್ರೈಸ್ ಭದ್ರತೆಯಲ್ಲಿ ಪ್ರಮಾಣಿತ ಅಭ್ಯಾಸವಾಗಿದೆ.
ಭಾಗ 6: 2026 ರಲ್ಲಿ ಎಕೋಸಿಸ್ಟಮ್
ನೇಟಿವ್ ವೆಕ್ಟರ್ ಡಾಟಾಬೇಸ್ಗಳು (ಉದ್ದೇಶಪೂರ್ವಕವಾಗಿ ನಿರ್ಮಿಸಿದವು)
ವೆಕ್ಟರ್ ಕಾರ್ಯಾಚರಣೆಗಳಿಗೆ ಆದ್ಯತೆ ನೀಡಲು ಇವುಗಳನ್ನು ಮೊದಲಿನಿಂದಲೂ ನಿರ್ಮಿಸಲಾಗಿದೆ:
-
Pinecone: ಸರ್ವರ್ಲೆಸ್, ಸಂಪೂರ್ಣವಾಗಿ ನಿರ್ವಹಿಸಲ್ಪಡುವ (ಡಾಟಾಬೇಸ್ ops ಪರಿಣತಿ ಇಲ್ಲದ ತಂಡಗಳಿಗೆ ಉತ್ತಮ)
-
Milvus: ಓಪನ್-ಸೋರ್ಸ್, ಅತ್ಯಂತ ಸ್ಕೇಲೆಬಲ್
-
Qdrant: ಓಪನ್-ಸೋರ್ಸ್, Rust ನಲ್ಲಿ ಬರೆಯಲ್ಪಟ್ಟಿದೆ, ಅತ್ಯಂತ ವೇಗವಾಗಿದೆ
-
Weaviate: ಕ್ಲೌಡ್ ಆಯ್ಕೆಗಳೊಂದಿಗೆ ಓಪನ್-ಸೋರ್ಸ್, ಜೆನೆರೇಟಿವ್ ಸರ್ಚ್ನಲ್ಲಿ ಪ್ರಬಲವಾಗಿದೆ
-
Chroma: ಸರಳ, ಪ್ರೊಟೊಟೈಪಿಂಗ್ ಮತ್ತು ಸಣ್ಣ-ಮಧ್ಯಮ ಯೋಜನೆಗಳಿಗೆ ಉತ್ತಮವಾಗಿದೆ
ಲೆಗಸಿ ಡಾಟಾಬೇಸ್ಗಳು ವೆಕ್ಟರ್ ಬೆಂಬಲವನ್ನು ಸೇರಿಸುತ್ತಿವೆ
ಸಾಂಪ್ರದಾಯಿಕ ಡಾಟಾಬೇಸ್ಗಳು ಪ್ರಸ್ತುತವಾಗಿರಲು ವೆಕ್ಟರ್ ಸಾಮರ್ಥ್ಯಗಳನ್ನು ಸೇರಿಸಿದವು:
-
PostgreSQL (with pgvector): ನೀವು ಈಗಾಗಲೇ Postgres ನಲ್ಲಿದ್ದರೆ, ಇದು ನೈಸರ್ಗಿಕ ವಿಸ್ತರಣೆಯಾಗಿದೆ
-
Redis: ತನ್ನ ಇನ್-ಮೆಮೊರಿ ಸ್ಟೋರ್ಗೆ ವೆಕ್ಟರ್ ಹುಡುಕಾಟವನ್ನು ಸೇರಿಸಿದೆ
-
Elasticsearch: ವೆಕ್ಟರ್ ಸಾಮೀಪ್ಯ ಹುಡುಕಾಟವನ್ನು ಸೇರಿಸಿದೆ
-
OpenSearch: ವೆಕ್ಟರ್ ಸಾಮರ್ಥ್ಯಗಳೊಂದಿಗೆ Elasticsearch ನ AWS ಫೋರ್ಕ್
2026 ರಲ್ಲಿ ಕಾರ್ಯತಂತ್ರದ ಆಯ್ಕೆ
2026 ರ ಮಧ್ಯಭಾಗದ ವೇಳೆಗೆ, ನಿರ್ಧಾರದ ಮ್ಯಾಟ್ರಿಕ್ಸ್ ಹೀಗಿದೆ:
-
AI ಯೊಂದಿಗೆ ಈಗಷ್ಟೇ ಪ್ರಾರಂಭಿಸುತ್ತಿದ್ದೀರಾ? Ops ವೆಚ್ಚವನ್ನು ತಡೆಗಟ್ಟಲು ನಿರ್ವಹಿಸಿದ ಸೇವೆಯನ್ನು (Pinecone) ಬಳಸಿ
-
ಈಗಾಗಲೇ Postgres ಮೂಲಸೌಕರ್ಯವನ್ನು ಹೊಂದಿದ್ದೀರಾ? pgvector ಅನ್ನು ಸೇರಿಸಿ ಮತ್ತು ಅದನ್ನು ನೀವೇ ನಿರ್ವಹಿಸಿ
-
ಕಸ್ಟಮ್ ಅಗತ್ಯತೆಗಳೊಂದಿಗೆ ದೊಡ್ಡ ಮಟ್ಟದಲ್ಲಿ ನಿರ್ಮಿಸುತ್ತಿದ್ದೀರಾ? Kubernetes ನಲ್ಲಿ Milvus ಅಥವಾ Qdrant ಅನ್ನು ನಿಯೋಜಿಸಿ
-
ಅಸ್ತಿತ್ವದಲ್ಲಿರುವ ಹುಡುಕಾಟದೊಂದಿಗೆ ನಿಕಟ ಏಕೀಕರಣ ಅಗತ್ಯವಿದೆಯೇ? Elasticsearch ಅಥವಾ OpenSearch ಅನ್ನು ಪರಿಗಣಿಸಿ
ಭಾಗ 7: ಅನುಷ್ಠಾನ: ನೀವು ನಿಜವಾಗಿ ಏನು ಮಾಡಬೇಕು
ನೀವು 2026 ರಲ್ಲಿ ವೆಕ್ಟರ್-ಚಾಲಿತ ವ್ಯವಸ್ಥೆಯನ್ನು ನಿರ್ಮಿಸುತ್ತಿದ್ದರೆ, ವಾಸ್ತವಿಕ ಹಂತ ಹಂತದ ಪ್ರಕ್ರಿಯೆ ಇಲ್ಲಿದೆ:
ಹಂತ 1: ನಿಮ್ಮ ಎಂಬೆಡಿಂಗ್ ಮಾಡೆಲ್ ಅನ್ನು ಆಯ್ಕೆಮಾಡಿ
ಇದು ಅಡಿಪಾಯವಾಗಿದೆ. ಎಂಬೆಡಿಂಗ್ ಮಾಡೆಲ್ ನಿರ್ಧರಿಸುತ್ತದೆ:
-
ಸೆಮ್ಯಾಂಟಿಕ್ ಅರ್ಥವನ್ನು ಎಷ್ಟು ಚೆನ್ನಾಗಿ ಗ್ರಹಿಸಲಾಗಿದೆ
-
ಆಯಾಮದ ಗಾತ್ರ (ಸಾಮಾನ್ಯವಾಗಿ 768-3072)
-
ಲೇಟೆನ್ಸಿ ಮತ್ತು ವೆಚ್ಚ
-
ನಿಮ್ಮ ಡೊಮೇನ್ಗೆ ಗುಣಮಟ್ಟ
2026 ರಲ್ಲಿ ಇರುವ ಆಯ್ಕೆಗಳು:
-
OpenAI ನ text-embedding-3-large: ಅತ್ಯುತ್ತಮ ಸಾಮಾನ್ಯ-ಉದ್ದೇಶ, ಪ್ರತಿ API ಕರೆಗೆ ಹಣ ವೆಚ್ಚವಾಗುತ್ತದೆ
-
Cohere Embeddings: ಉತ್ತಮ ಗುಣಮಟ್ಟ, ಪ್ರತಿ-ಟೋಕನ್ಗೆ-ಪಾವತಿಸುವ ಮಾಡೆಲ್
-
ಓಪನ್-ಸೋರ್ಸ್ ಪರ್ಯಾಯಗಳು (HuggingFace ನಿಂದ): E5-large, BGE-large (ಉಚಿತ, ಸ್ವಯಂ-ಹೋಸ್ಟ್ ಮಾಡಲಾದ)
ಹಂತ 2: ನಿಮ್ಮ ಡೇಟಾವನ್ನು ಸಿದ್ಧಪಡಿಸಿ
ಇಲ್ಲಿ ಶೇಕಡಾ 70% ರಷ್ಟು ಕೆಲಸ ಇರುತ್ತದೆ. ನೀವು ಇದನ್ನು ಮಾಡಬೇಕು:
- ನಿಮ್ಮ ಡೇಟಾ ಮೂಲವನ್ನು ಪತ್ತೆಹಚ್ಚಿ. ನಿಮ್ಮ ವ್ಯವಹಾರ-ಸಂಕೀರ್ಣ ಮಾಹಿತಿ ಎಲ್ಲಿದೆ? ದಾಖಲೆಗಳಲ್ಲಿದೆಯೇ? ಡಾಟಾಬೇಸ್ ದಾಖಲೆಗಳಲ್ಲಿದೆಯೇ? ಗ್ರಾಹಕರ ಪರಸ್ಪರ ಕ್ರಿಯೆಗಳಲ್ಲಿದೆಯೇ?
- ನಿಮ್ಮ ಡೇಟಾವನ್ನು ಸೂಕ್ತವಾಗಿ ಚಂಕ್ ಮಾಡಿ. 50-ಪುಟಗಳ ದಾಖಲೆಯನ್ನು ಒಂದೇ ವೆಕ್ಟರ್ ಆಗಿ ನೀಡುವುದು ಮಾಹಿತಿಯನ್ನು ವ್ಯರ್ಥ ಮಾಡುತ್ತದೆ. ನೀವು ಅರ್ಥಪೂರ್ಣ ಚಂಕ್ಗಳಾಗಿ (ಸಾಮಾನ್ಯವಾಗಿ 200-500 ಟೋಕನ್ಗಳು) ವಿಭಜಿಸಬೇಕಾಗಿದೆ. ತುಂಬಾ ಸಣ್ಣದಾಗಿದ್ದರೆ ಸಂದರ್ಭವನ್ನು ಕಳೆದುಕೊಳ್ಳುತ್ತೀರಿ. ತುಂಬಾ ದೊಡ್ಡದಾಗಿದ್ದರೆ ಪ್ರಸ್ತುತತೆ ಅಸ್ಪಷ್ಟವಾಗುತ್ತದೆ.
- ಮೆಟಾಡೇಟಾವನ್ನು ನಿರ್ವಹಿಸಿ. ವೆಕ್ಟರ್ ಅನ್ನು ಮಾತ್ರ ಸಂಗ್ರಹಿಸಬೇಡಿ. ಮೂಲ ಪಠ್ಯ, ಆಕರ ದಾಖಲೆ, ಸಮಯದ ಮುದ್ರೆ, ಮತ್ತು ಯಾವುದೇ ಫಿಲ್ಟರಿಂಗ್ ಮೆಟಾಡೇಟಾವನ್ನು ಸಂಗ್ರಹಿಸಿ. ಸಂದರ್ಭವಿಲ್ಲದೆ ವೆಕ್ಟರ್ ಒಂದೇ ಅರ್ಥಹೀನವಾಗಿರುತ್ತದೆ.
- ನಿಮ್ಮ ಎಂಬೆಡಿಂಗ್ಗಳನ್ನು ಆವೃತ್ತಿಗೊಳಿಸಿ. ನಿಮ್ಮ ಎಂಬೆಡಿಂಗ್ ಮಾಡೆಲ್ ಅನ್ನು ನೀವು ಅಪ್ಗ್ರೇಡ್ ಮಾಡಿದರೆ, ಹಳೆಯ ವೆಕ್ಟರ್ಗಳು ಹೊಂದಾಣಿಕೆಯಾಗುವುದಿಲ್ಲ. ಮರುಸಂಸ್ಕರಣೆಗೆ ಯೋಜಿಸಿ.
ಹಂತ 3: ವೆಕ್ಟರ್ ಡಾಟಾಬೇಸ್ ಅನ್ನು ನಿಯೋಜಿಸಿ
ನಿಯೋಜನೆ ತಂತ್ರವನ್ನು ನಿರ್ಧರಿಸಿ:
ಆಯ್ಕೆ A: ಮ್ಯಾನೇಜ್ಡ್ ಸರ್ವಿಸ್ (ಹೆಚ್ಚಿನ ತಂಡಗಳಿಗೆ ಅತ್ಯಂತ ಸುಲಭ)
-
ಸೇವೆ: Pinecone, Supabase Vector, ಅಥವಾ Azure OpenAI ಎಂಬೆಡಿಂಗ್ ಸೇವೆ
-
ಸೆಟಪ್: 30 ನಿಮಿಷಗಳು
-
ವೆಚ್ಚ: ಪಾವತಿಸಿ-ಬಳಸಿ, ಸಾಮಾನ್ಯವಾಗಿ ಪ್ರತಿ ಮಿಲಿಯನ್ ವೆಕ್ಟರ್ಗಳಿಗೆ $0.50-$2.00
-
ನಿರ್ವಹಣೆ: ಶೂನ್ಯ (ಪೂರೈಕೆದಾರರಿಂದ ನಿರ್ವಹಿಸಲ್ಪಡುತ್ತದೆ)
ಆಯ್ಕೆ B: ಸೆಲ್ಫ್-ಹೋಸ್ಟೆಡ್ (ಗರಿಷ್ಠ ನಿಯಂತ್ರಣ)
-
ನಿಯೋಜಿಸಿ: ನಿಮ್ಮ Kubernetes ಕ್ಲಸ್ಟರ್ಗೆ Milvus ಅಥವಾ Qdrant
-
ಸಂಯೋಜನೆ: ಕಾನ್ಫಿಗರೇಶನ್ ಮತ್ತು ಪರೀಕ್ಷೆ ಸೇರಿದಂತೆ 2-3 ದಿನಗಳು
-
ವೆಚ್ಚ: ಮೂಲಸೌಕರ್ಯ ವೆಚ್ಚಗಳು (ಸರ್ವರ್ಗಳು/ಸ್ಟೋರೇಜ್) ಮತ್ತು ಕಾರ್ಯಾಚರಣೆಯ ಓವರ್ಹೆಡ್
-
ನಿರ್ವಹಣೆ: ನಿಮ್ಮ ತಂಡವು ಉಸ್ತುವಾರಿ, ಬ್ಯಾಕಪ್ಗಳು ಮತ್ತು ಸ್ಕೇಲಿಂಗ್ ಅನ್ನು ನಿರ್ವಹಿಸುತ್ತದೆ
ಹಂತ 4: ಇಂಜೆಷನ್ ಪೈಪ್ಲೈನ್ ಅನ್ನು ನಿರ್ಮಿಸಿ
ನಿರಂತರವಾಗಿ ಕೆಳಗಿನವುಗಳನ್ನು ಮಾಡುವ ವ್ಯವಸ್ಥೆಯನ್ನು ರಚಿಸಿ:
- ಹೊಸ/ಬದಲಾದ ಡೇಟಾಗಾಗಿ ನಿಮ್ಮ ಡೇಟಾ ಮೂಲವನ್ನು ಉಸ್ತುವಾರಿ ವಹಿಸುತ್ತದೆ
- ಹೊಸ ವಿಷಯಕ್ಕಾಗಿ ಎಂಬೆಡ್ಡಿಂಗ್ಗಳನ್ನು ಜನರೇಟ್ ಮಾಡುತ್ತದೆ
- ಡೇಟಾಬೇಸ್ನಲ್ಲಿ ವೆಕ್ಟರ್ಗಳನ್ನು ಸೇರಿಸುತ್ತದೆ ಅಥವಾ ಅಪ್ಡೇಟ್ ಮಾಡುತ್ತದೆ
- ಆಡಿಟ್ ಲಾಗ್ಗಳನ್ನು ನಿರ್ವಹಿಸುತ್ತದೆ (ಯಾವಾಗ ಏನು ಬದಲಾಯಿತು)
ಇದು ಒಂದು ಬಾರಿಯ ಬ್ಯಾಚ್ ಪ್ರಕ್ರಿಯೆಯಲ್ಲ. ನೈಜ ವ್ಯವಸ್ಥೆಗಳು ನಿರಂತರವಾಗಿ ಹೊಸ ಡೇಟಾವನ್ನು ಇಂಜೆಸ್ಟ್ ಮಾಡುತ್ತವೆ.
ಹಂತ 5: ಕ್ವೆರಿ ಲಾಜಿಕ್ ಅನ್ನು ಜಾರಿಗೊಳಿಸಿ
ಬಳಕೆದಾರರು ಹುಡುಕಿದಾಗ ಅಥವಾ ನಿಮ್ಮ ವ್ಯವಸ್ಥೆಯು ಸಂಬಂಧಿತ ಮಾಹಿತಿಯನ್ನು ಹಿಂಪಡೆಯಬೇಕಾದಾಗ:
- ಅವರ ಕ್ವೆರಿಯನ್ನು ವೆಕ್ಟರ್ಗೆ ಪರಿವರ್ತಿಸಿ (ತರಬೇತಿ ಡೇಟಾದಂತೆಯೇ ಅದೇ ಎಂಬೆಡ್ಡಿಂಗ್ ಮಾಡೆಲ್)
- ವೆಕ್ಟರ್ ಸಿಮಿಲಾರಿಟಿ ಸರ್ಚ್ ಅನ್ನು ರನ್ ಮಾಡಿ (ಟಾಪ್-k ಹತ್ತಿರದ ನೆರೆಹೊರೆಯವರನ್ನು ಹಿಂಪಡೆಯಿರಿ)
- ಫಲಿತಾಂಶಗಳ ಪೋಸ್ಟ್-ಪ್ರೊಸೆಸಿಂಗ್ ಮಾಡಿ (ಫಿಲ್ಟರ್ ಮಾಡಿ, ಮರು-ರ್ಯಾಂಕ್ ಮಾಡಿ, ಅಗತ್ಯವಿದ್ದರೆ ಸಾಂಪ್ರದಾಯಿಕ ಹುಡುಕಾಟದೊಂದಿಗೆ ಸಂಯೋಜಿಸಿ)
- ನಿಮ್ಮ ಅಪ್ಲಿಕೇಶನ್ಗೆ ಕಾಂಟೆಕ್ಸ್ಟ್ ಅನ್ನು ಹಿಂತಿರುಗಿಸಿ (ಒಂದು LLM, ರೆಕಮೆಂಡೇಶನ್ ಎಂಜಿನ್ ಇತ್ಯಾದಿಗಳಿಗೆ)
ಹಂತ 6: ಉಸ್ತುವಾರಿ ವಹಿಸಿ ಮತ್ತು ಪುನರಾವರ್ತಿಸಿ
2026 ರಲ್ಲಿ, ಪ್ರೊಡಕ್ಷನ್ AI ವ್ಯವಸ್ಥೆಗಳಿಗೆ ನಿರಂತರ ಉಸ್ತುವಾರಿ ಅಗತ್ಯವಿರುತ್ತದೆ:
-
ಎಂಬೆಡ್ಡಿಂಗ್ ಗುಣಮಟ್ಟ: ನಿಮ್ಮ ಚಂಕ್ಗಳು ತುಂಬಾ ದೊಡ್ಡದಾಗಿವೆಯೇ? ತುಂಬಾ ಚಿಕ್ಕದಾಗಿವೆಯೇ? ಸೆಮ್ಯಾಂಟಿಕ್ ಅರ್ಥವನ್ನು ಗ್ರಹಿಸಲಾಗುತ್ತಿದೆಯೇ?
-
ಕ್ವೆರಿ ಕಾರ್ಯಕ್ಷಮತೆ: ಕ್ವೆರಿಗಳು ಸ್ವೀಕಾರಾರ್ಹ ಸಮಯದಲ್ಲಿ ಪೂರ್ಣಗೊಳ್ಳುತ್ತಿವೆಯೇ (<500ms ಸಾಮಾನ್ಯವಾಗಿದೆ)?
-
ವೆಕ್ಟರ್ ಸ್ಪೇಸ್ ಡ್ರಿಫ್ಟ್: ಸಮಯ ಕಳೆದಂತೆ ನಿಮ್ಮ ಡೇಟಾದ ಅರ್ಥ ಬದಲಾಗುತ್ತದೆಯೇ? (ರೆಕಮೆಂಡೇಶನ್ ಸಿಸ್ಟಮ್ಗಳಲ್ಲಿ ಸಾಮಾನ್ಯ)
-
ಬಳಕೆದಾರರ ತೃಪ್ತಿ: ನಿಮ್ಮ RAG ಫಲಿತಾಂಶಗಳು ನಿಜವಾಗಿಯೂ ಉಪಯುಕ್ತವಾಗಿವೆಯೇ? ಪ್ರತಿಕ್ರಿಯೆಯನ್ನು ಟ್ರ್ಯಾಕ್ ಮಾಡಿ.
ಭಾಗ 8: ಅನುಕೂಲಗಳು (ಇದು ಏಕೆ ಮುಖ್ಯ)
ಅನುಕೂಲ 1: ದೊಡ್ಡ ಪ್ರಮಾಣದಲ್ಲಿ ಸೆಮ್ಯಾಂಟಿಕ್ ಗ್ರಹಿಕೆ
ಸಾಂಪ್ರದಾಯಿಕ ಕೀವರ್ಡ್ ಹುಡುಕಾಟಕ್ಕಿಂತ ಭಿನ್ನವಾಗಿ, ನೀವು ಅಂತಿಮವಾಗಿ ಅರ್ಥವನ್ನು ಗ್ರಹಿಸುವ ವ್ಯವಸ್ಥೆಗಳನ್ನು ಪಡೆಯುತ್ತೀರಿ. ಒಬ್ಬ ಗ್ರಾಹಕರು "fast computer" ಗಾಗಿ ಹುಡುಕಿದಾಗ, ಆ ನಿಖರವಾದ ನುಡಿಗಟ್ಟುಗಳು ಉತ್ಪನ್ನದ ಪಟ್ಟಿಯಲ್ಲಿ ಕಾಣಿಸದಿದ್ದರೂ ಸಹ "high-performance laptop", "gaming desktop", ಮತ್ತು "workstation" ಗಳ ಸಿಫಾರಸುಗಳನ್ನು ಪಡೆಯುತ್ತಾರೆ.
ಅನುಕೂಲ 2: LLM ಗಳಲ್ಲಿ ಭ್ರಮೆಯನ್ನು ಕಡಿಮೆ ಮಾಡುತ್ತದೆ
retrieval-augmented generation ಗಾಗಿ ವೆಕ್ಟರ್ ಡೇಟಾಬೇಸ್ನೊಂದಿಗೆ LLM ಅನ್ನು ಜೋಡಿಸುವುದು ಕಳೆದ 3 ವರ್ಷಗಳಲ್ಲಿ ಎಂಟರ್ಪ್ರೈಸ್ AI ನಲ್ಲಿ ಅತ್ಯಂತ ಪ್ರಮುಖ ಬೆಳವಣಿಗೆಯಾಗಿದೆ. ಇದು ಭಾಷಾ ಮಾದರಿಗಳನ್ನು ನೈಜ ಡೇಟಾದಲ್ಲಿ ಆಧಾರವಾಗಿಸುವ ಮೂಲಕ ಭ್ರಮೆಯ ಸಮಸ್ಯೆಯನ್ನು ಪರಿಹರಿಸುತ್ತದೆ.
ಅನುಕೂಲ 3: ವಿವಿಧ ಮಾದರಿಗಳಲ್ಲಿ ಕಾರ್ಯನಿರ್ವಹಿಸುತ್ತದೆ
ವೆಕ್ಟರ್ಗಳು ಕೇವಲ ಪಠ್ಯಕ್ಕೆ ಮಾತ್ರವಲ್ಲ. ಅದೇ ಆರ್ಕಿಟೆಕ್ಚರ್ ಕೆಳಗಿನವುಗಳನ್ನು ನಿರ್ವಹಿಸುತ್ತದೆ:
-
ಚಿತ್ರಗಳು (ಚಿತ್ರ ಹುಡುಕಾಟ, ದೃಶ್ಯ ಹೋಲಿಕೆ)
-
ಆಡಿಯೋ (ಆಡಿಯೋ ಫಿಂಗರ್ಪ್ರಿಂಟಿಂಗ್, ಸಂಗೀತ ಸಿಫಾರಸು)
-
ವೀಡಿಯೋ (ದೃಶ್ಯ ಪತ್ತೆ, ವಿಷಯ ಸಿಫಾರಸು)
-
ಮಿಶ್ರ ಮಾಧ್ಯಮ (ಪಠ್ಯ ವಿವರಣೆಗೆ ಹೋಲುವ ಚಿತ್ರಗಳನ್ನು ಹುಡುಕಿ)
ಅನುಕೂಲ 4: ಗಮನಾರ್ಹವಾಗಿ ಉತ್ತಮವಾದ ಬಳಕೆದಾರ ಅನುಭವ
ವಾಸ್ತವ-ಪ್ರಪಂಚದ ಫಲಿತಾಂಶಗಳು: ವೆಕ್ಟರ್ ಸಿಮಿಲಾರಿಟಿ ಮೂಲಕ ಚಾಲಿತಗೊಳ್ಳುವ ರೆಕಮೆಂಡೇಶನ್ ಸಿಸ್ಟಮ್ಗಳು ತೊಡಗಿಸಿಕೊಳ್ಳುವಿಕೆಯ ಮೆಟ್ರಿಕ್ಗಳಲ್ಲಿ ಸಾಂಪ್ರದಾಯಿಕ ವಿಧಾನಗಳಿಗಿಂತ 25-40% ರಷ್ಟು ನಿರಂತರವಾಗಿ ಉತ್ತಮವಾಗಿ ಕಾರ್ಯನಿರ್ವಹಿಸುತ್ತವೆ.
ಅನುಕೂಲ 5: ಸುಧಾರಿತ ಅನೋಮಲಿ ಡಿಟೆಕ್ಷನ್ಗೆ ಅನುವು ಮಾಡಿಕೊಡುತ್ತದೆ
ಸುರಕ್ಷತೆ, ವಂಚನೆ ಪತ್ತೆ ಮತ್ತು ಗುಣಮಟ್ಟದ ಭರವಸೆಯಲ್ಲಿ, ಸ್ಪಷ್ಟ ನಿಯಮಗಳಿಲ್ಲದೆ "ಸಾಮಾನ್ಯವಾಗಿ ಕಾಣಿಸದ ವಿಷಯಗಳನ್ನು" ಗುರುತಿಸುವ ಸಾಮರ್ಥ್ಯವು ಪರಿವರ್ತನಕಾರಿಯಾಗಿದೆ. ಪ್ರತಿಯೊಂದು ಸಂಭಾವ್ಯ ದಾಳಿಯ ಮಾದರಿಯನ್ನು ನೀವು ತಿಳಿಯಬೇಕಾಗಿಲ್ಲ. ವೆಕ್ಟರ್ ಸ್ಪೇಸ್ನಲ್ಲಿ ಇದು ಸಾಮಾನ್ಯ ನಡವಳಿಕೆಯಿಂದ ದೂರವಿದ್ದರೆ, ಅದು ಅನುಮಾನಾಸ್ಪದವಾಗಿದೆ.
ಭಾಗ 9: ಅನಾನುಕೂಲಗಳು (ನೈಜ ಮಿತಿಗಳು)
ಅನಾನುಕೂಲ 1: "Garbage In, Garbage Out" ಹೆಚ್ಚು ಕಟ್ಟುನಿಟ್ಟಾಗಿ ಅನ್ವಯಿಸುತ್ತದೆ
ನಿಮ್ಮ ವೆಕ್ಟರ್ ಡೇಟಾಬೇಸ್ ಕೆಳಗಿನವುಗಳ ಗುಣಮಟ್ಟದಷ್ಟೇ ಉತ್ತಮವಾಗಿರುತ್ತದೆ:
-
ನಿಮ್ಮ ಎಂಬೆಡ್ಡಿಂಗ್ ಮಾಡೆಲ್ನ ಗುಣಮಟ್ಟ
-
ನಿಮ್ಮ ತರಬೇತಿ ಡೇಟಾದ ಪ್ರಸ್ತುತತೆ
-
ನಿಮ್ಮ ಚಂಕಿಂಗ್ ತಂತ್ರ
-
ನಿಮ್ಮ ಮೆಟಾಡೇಟಾ ಗುಣಮಟ್ಟ
ಇವುಗಳಲ್ಲಿ ಯಾವುದಾದರೂ ಒಂದರಲ್ಲಿ ತಪ್ಪಾದ ನಿರ್ಧಾರವು ಇಡೀ ವ್ಯವಸ್ಥೆಯನ್ನು ಕೆಡಿಸುತ್ತದೆ. ಕಳಪೆ ಅಡಿಪಾಯದಿಂದ ಹೊರಬರಲು ಕ್ವೆರಿ ಮಾಡಲು ಯಾವುದೇ ಮಾರ್ಗವಿಲ್ಲ.
ಅನಾನುಕೂಲ 2: ಎಂಬೆಡ್ಡಿಂಗ್ ಗುಣಮಟ್ಟವು ಸ್ಪಷ್ಟವಾಗಿರುವುದಿಲ್ಲ
ನಿಖರವಾದ ಫಲಿತಾಂಶಗಳನ್ನು ನೀಡುವ ಡೇಟಾಬೇಸ್ ಕ್ವೆರಿಗಿಂತ ಭಿನ್ನವಾಗಿ, ವೆಕ್ಟರ್ ಹುಡುಕಾಟಗಳು "ಸಾಕಷ್ಟು ಹೋಲುವ" ಫಲಿತಾಂಶಗಳನ್ನು ನೀಡುತ್ತವೆ. ಆದರೆ ಯಾವ ಮೆಟ್ರಿಕ್ಗಳ ಪ್ರಕಾರ ಹೋಲುತ್ತವೆ? ವಿಭಿನ್ನ ಎಂಬೆಡ್ಡಿಂಗ್ ಮಾಡೆಲ್ಗಳು ಸಿಮಿಲಾರಿಟಿಯನ್ನು ವಿಭಿನ್ನವಾಗಿ ರ್ಯಾಂಕ್ ಮಾಡುತ್ತವೆ. ಬಳಕೆದಾರರು ದೂರುವವರೆಗೆ ನಿಮ್ಮ ಪ್ರೊಡಕ್ಷನ್ ಸಿಸ್ಟಮ್ ಅಪೂರ್ಣ ಫಲಿತಾಂಶಗಳನ್ನು ನೀಡುತ್ತಿರುವುದು ನಿಮಗೆ ತಿಳಿಯದಿರಬಹುದು.
ಅನಾನುಕೂಲ 3: ಸ್ಕೇಲೆಬಿಲಿಟಿ ಉಚಿತವಲ್ಲ
ಕೋಟಿಗಟ್ಟಲೆ ವೆಕ್ಟರ್ಗಳಿದ್ದಾಗ, ಅಂದಾಜು ಹತ್ತಿರದ ನೆರೆಹೊರೆಯವರ ಹುಡುಕಾಟವೂ ದುಬಾರಿಯಾಗುತ್ತದೆ:
-
ಕಂಪ್ಯೂಟ್: ಪ್ರತಿಯೊಂದು ಕ್ವೆರಿಯು ಲಕ್ಷಾಂತರ ವೆಕ್ಟರ್ಗಳಲ್ಲಿ ಗಣಿತದ ಲೆಕ್ಕಾಚಾರಗಳನ್ನು ಒಳಗೊಂಡಿರುತ್ತದೆ
-
ಸ್ಟೋರೇಜ್: ಹೈ-ಡೈಮೆನ್ಷನಲ್ ವೆಕ್ಟರ್ಗಳು ಗಮನಾರ್ಹ ಜಾಗವನ್ನು ತೆಗೆದುಕೊಳ್ಳುತ್ತವೆ (1536 ಆಯಾಮಗಳಲ್ಲಿ 1 ಬಿಲಿಯನ್ ವೆಕ್ಟರ್ಗಳು ≈ 6TB ಸ್ಟೋರೇಜ್)
-
ಮೆಮೊರಿ: ವೇಗಕ್ಕಾಗಿ ಇಂಡೆಕ್ಸ್ಗಳನ್ನು RAM ನಲ್ಲಿ ಇಡುವುದು ಎಂದರೆ ಹೆಚ್ಚಿನ ಮೂಲಸೌಕರ್ಯ ವೆಚ್ಚಗಳು
ಅನಾನುಕೂಲ 4: ವೆಂಡರ್ ಲಾಕ್-ಇನ್ ಅಪಾಯ
ನೀವು ಮ್ಯಾನೇಜ್ಡ್ ವೆಕ್ಟರ್ ಡೇಟಾಬೇಸ್ ಪೂರೈಕೆದಾರರ ಮೇಲೆ ಹೆಚ್ಚು ಅವಲಂಬಿತರಾಗಿದ್ದರೆ, ಪೂರೈಕೆದಾರರನ್ನು ಬದಲಾಯಿಸುವುದು ದುಬಾರಿಯಾಗುತ್ತದೆ. ನಿಮ್ಮ ವೆಕ್ಟರ್ಗಳನ್ನು ರಫ್ತು ಮಾಡಿ ಬೇರೆ ಸಿಸ್ಟಮ್ಗೆ ಸೇರಿಸಲು ಸಾಧ್ಯವಿಲ್ಲ—ವೆಕ್ಟರ್ ಸ್ಪೇಸ್ಗಳು ಮಾಡೆಲ್-ನಿರ್ದಿಷ್ಟವಾಗಿರುತ್ತವೆ.
ಅನಾನುಕೂಲ 5: ಸೆಮ್ಯಾಂಟಿಕ್ ಸ್ಪೇಸ್ ಸ್ಥಿರವಾಗಿರುವುದಿಲ್ಲ
ಇದು ಸೂಕ್ಷ್ಮ ಆದರೆ ಮುಖ್ಯವಾಗಿದೆ: ನೀವು ಹೆಚ್ಚಿನ ಡೇಟಾವನ್ನು ಸೇರಿಸಿದಂತೆ, ಆಧಾರವಾಗಿರುವ ವೆಕ್ಟರ್ ಸ್ಪೇಸ್ ಸಂಬಂಧಗಳು ಬದಲಾಗಬಹುದು. ನೀವು ಹೊಸ ಡೇಟಾವನ್ನು ಇಂಜೆಸ್ಟ್ ಮಾಡಿದ ನಂತರ "finance" ಕ್ಲಸ್ಟರ್ನಲ್ಲಿದ್ದ ವೆಕ್ಟರ್ "insurance" ಹತ್ತಿರ ಕೊನೆಗೊಳ್ಳಬಹುದು. ಇದು ಸಾಮಾನ್ಯವಾಗಿ ಒಳ್ಳೆಯದು (ಹೆಚ್ಚು ನಿಖರ) ಆದರೆ ಪ್ರೊಡಕ್ಷನ್ನಲ್ಲಿ ನಿಮಗೆ ಆಶ್ಚರ್ಯ ಉಂಟುಮಾಡಬಹುದು.
ಭಾಗ 10: ನಿರ್ಣಾಯಕ ಎಚ್ಚರಿಕೆಗಳು (ನಿಮ್ಮ ಸ್ವಂತ ಅಪಾಯದಲ್ಲಿ ಇದನ್ನು ಮಾಡಿ)
ಎಚ್ಚರಿಕೆ 1: ವೆಕ್ಟರ್ಗಳು ಒಂದು ಮಾಂತ್ರಿಕ ಪರಿಹಾರ ಎಂದು ಭಾವಿಸಬೇಡಿ
AI ಮ್ಯಾಜಿಕ್ ಅನ್ನು ನಿರೀಕ್ಷಿಸಿ ವೆಕ್ಟರ್ ಡೇಟಾಬೇಸ್ಗಳನ್ನು ಜಾರಿಗೆ ತಂದ ತಂಡಗಳು ಸಾಧಾರಣ ಫಲಿತಾಂಶಗಳನ್ನು ಪಡೆಯುವುದನ್ನು ನಾವು ನೋಡಿದ್ದೇವೆ. ತಂತ್ರಜ್ಞಾನವು ಪ್ರಬಲವಾಗಿದೆ ಆದರೆ ಆಲೋಚನಾಪೂರ್ವಕ ಅನುಷ್ಠಾನದ ಅಗತ್ಯವಿದೆ. ಕಳಪೆ ಎಂಬೆಡ್ಡಿಂಗ್ಗಳು + ಕಳಪೆ ಚಂಕಿಂಗ್ = ಕಳಪೆ ಫಲಿತಾಂಶಗಳು, ಡೇಟಾಬೇಸ್ ಎಷ್ಟೇ ಸುಧಾರಿತವಾಗಿದ್ದರೂ ಸಹ.
ಎಚ್ಚರಿಕೆ 2: ನಿಮ್ಮ ಎಂಬೆಡ್ಡಿಂಗ್ ವೆಚ್ಚಗಳನ್ನು ಮೇಲ್ವಿಚಾರಣೆ ಮಾಡಿ
ನೀವು API-ಆಧಾರಿತ ಎಂಬೆಡ್ಡಿಂಗ್ ಸೇವೆಯನ್ನು (OpenAI, Cohere) ಬಳಸುತ್ತಿದ್ದರೆ, ದೊಡ್ಡ ಪ್ರಮಾಣದ ಇಂಜೆಷನ್ ವೇಗವಾಗಿ ದುಬಾರಿಯಾಗುತ್ತದೆ. ಪ್ರಸ್ತುತ ಬೆಲೆಯಲ್ಲಿ 10 ಮಿಲಿಯನ್ ದಾಖಲೆಗಳನ್ನು ಎಂಬೆಡ್ ಮಾಡುವುದು ಟೋಕನ್ ಎಣಿಕೆಯನ್ನು ಅವಲಂಬಿಸಿ $5,000-$15,000 ವೆಚ್ಚವಾಗಬಹುದು. ಅದಕ್ಕೆ ತಕ್ಕಂತೆ ಬಜೆಟ್ ಮಾಡಿ.
ಎಚ್ಚರಿಕೆ 3: ನಿಮ್ಮ ಗೌಪ್ಯತೆ/ಅನುಸರಣೆ ಬದ್ಧತೆಗಳನ್ನು ಅರ್ಥಮಾಡಿಕೊಳ್ಳಿ
ವೆಕ್ಟರ್ಗಳನ್ನು ನಿಮ್ಮ ಮೂಲ ಡೇಟಾದಿಂದ ಪಡೆಯಲಾಗಿದೆ. ನಿಮ್ಮ ಡೇಟಾ GDPR, HIPAA ಅಥವಾ ಇತರ ನಿಯಮಗಳಿಗೆ ಒಳಪಟ್ಟಿದ್ದರೆ:
-
ವೆಕ್ಟರ್ ಡೇಟಾಬೇಸ್ ಸೈದ್ಧಾಂತಿಕವಾಗಿ ರಿವರ್ಸ್-ಎಂಜಿನಿಯರ್ ಮಾಡಬಹುದಾದ ಮಾಹಿತಿಯನ್ನು ಸಂಗ್ರಹಿಸುತ್ತದೆ
-
ಹಳೆಯ ವೆಕ್ಟರ್ಗಳಿಗಾಗಿ ನಿಮಗೆ ಅಳಿಸುವಿಕೆಯ ನೀತಿಗಳು ಅಗತ್ಯವಿದೆ
-
ಆಡಿಟ್ ಲಾಗಿಂಗ್ ನಿರ್ಣಾಯಕವಾಗಿದೆ
ನಿಯಂತ್ರಿತ ಉದ್ಯಮಗಳಲ್ಲಿ ನಿಯೋಜಿಸುವ ಮೊದಲು ಕಾನೂನು/ಅನುಸರಣೆ ತಂಡವನ್ನು ಸಂಪರ್ಕಿಸಿ.
ಎಚ್ಚರಿಕೆ 4: ವೆಕ್ಟರ್ ಸರ್ಚ್ ಟ್ರಾನ್ಸಾಕ್ಷನಲ್ ಅಲ್ಲ
ಸಾಂಪ್ರದಾಯಿಕ ಡೇಟಾಬೇಸ್ಗಳಿಗಿಂತ ಭಿನ್ನವಾಗಿ, ವೆಕ್ಟರ್ ಡೇಟಾಬೇಸ್ಗಳು ACID ಗ್ಯಾರಂಟಿಗಳನ್ನು ನೀಡುವುದಿಲ್ಲ. ಇಂಜೆಷನ್ ಸಮಯದಲ್ಲಿ ನಿಮ್ಮ ಸಿಸ್ಟಮ್ ಕ್ರಾಶ್ ಆದರೆ, ನೀವು ಅಸಮಂಜಸ ಸ್ಥಿತಿಯನ್ನು ಹೊಂದಿರಬಹುದು. ಇದು ರೆಕಮೆಂಡೇಶನ್ ಸಿಸ್ಟಮ್ಗಳಿಗೆ ಸರಿಯಾಗಿದೆ ಆದರೆ ಅನುಸರಣೆ-ಸಂವೇದನಾಶೀಲ ಅಪ್ಲಿಕೇಶನ್ಗಳಿಗೆ ಅಪಾಯಕಾರಿ. ನಿಮ್ಮ ಸ್ವಂತ ಕನ್ಸಿಸ್ಟೆನ್ಸಿ ಪರಿಶೀಲನೆಗಳನ್ನು ಜಾರಿಗೆ ತನ್ನಿ.
ಎಚ್ಚರಿಕೆ 5: ಕೋಲ್ಡ್ ಸ್ಟಾರ್ಟ್ ಸಮಸ್ಯೆ ನೈಜವಾಗಿದೆ
ಲಕ್ಷಾಂತರ ಉತ್ತಮ ಗುಣಮಟ್ಟದ ವೆಕ್ಟರ್ಗಳನ್ನು ಹೊಂದಿರುವ ವೆಕ್ಟರ್ ಡೇಟಾಬೇಸ್ ಶಕ್ತಿಶಾಲಿಯಾಗಿದೆ. 100 ವೆಕ್ಟರ್ಗಳನ್ನು ಹೊಂದಿರುವ ವೆಕ್ಟರ್ ಡೇಟಾಬೇಸ್ ಬಹುಮಟ್ಟಿಗೆ ನಿರುಪಯುಕ್ತವಾಗಿದೆ. ನಿಮ್ಮ ಪ್ರಾರ೦ಭಿಕ ಡೇಟಾ ಲೋಡ್ ಗುಣಮಟ್ಟವು ಅತ್ಯಂತ ಮುಖ್ಯವಾಗಿದೆ. ಅಪೂರ್ಣ ತರಬೇತಿ ಡೇಟಾದೊಂದಿಗೆ ನಿಯೋಜಿಸಬೇಡಿ.
ಎಚ್ಚರಿಕೆ 6: ಪ್ರೊಡಕ್ಷನ್ಗಿಂತ ಮೊದಲು ಪರೀಕ್ಷಿಸಿ
2026 ರಲ್ಲಿ, ಪರೀಕ್ಷಿಸದ AI ವ್ಯವಸ್ಥೆಗಳನ್ನು ನಿಯೋಜಿಸಲು ಯಾವುದೇ ಕ್ಷಮಿಸಬಾರದ ನೆಪಗಳಿಲ್ಲ. ಮೌಲ್ಯೀಕರಿಸಿ:
-
ಮಾದರಿ ಡೇಟಾದಲ್ಲಿ ಎಂಬೆಡ್ಡಿಂಗ್ ಗುಣಮಟ್ಟ
-
ಹುಡುಕಾಟದ ನಿಖರತೆ (ವ್ಯವಸ್ಥೆಯು ಸಂಬಂಧಿತ ಫಲಿತಾಂಶಗಳನ್ನು ಹಿಂತಿರುಗಿಸುತ್ತದೆಯೇ?)
-
ವಾಸ್ತವಿಕ ಲೋಡ್ ಅಡಿಯಲ್ಲಿ ಕಾರ್ಯಕ್ಷಮತೆ
-
ವೆಚ್ಚದ ಅಂದಾಜುಗಳು
ಪೂರ್ಣ ರೋಲ್ಔಟ್ಗೆ ಮೊದಲು ನೈಜ ಬಳಕೆದಾರರೊಂದಿಗೆ ಸಂಪೂರ್ಣ ಪೈಲಟ್ ಚಾಲನೆ ಮಾಡಿ.
ತೀರ್ಮಾನ: ವೆಕ್ಟರ್ ಡೇಟಾಬೇಸ್ಗಳು ಈಗ ಮೂಲಸೌಕರ್ಯವಾಗಿವೆ
ಜೂನ್ 2026 ರಲ್ಲಿ, ವೆಕ್ಟರ್ ಡೇಟಾಬೇಸ್ಗಳು "ಆಸಕ್ತಿದಾಯಕ ಸಂಶೋಧನಾ ಯೋಜನೆ" ಯಿಂದ "ಯಾವುದೇ AI ವ್ಯವಸ್ಥೆಗೆ ಅಗತ್ಯವಾದ ಮೂಲಸೌಕರ್ಯ" ಗೆ ಬದಲಾಗಿವೆ.
ನೀವು ಒಂದು ವೇಳೆ:
-
ರೆಕಮೆಂಡೇಶನ್ ಸಿಸ್ಟಮ್ಗಳನ್ನು ನಿರ್ಮಿಸುತ್ತಿದ್ದರೆ: ವೆಕ್ಟರ್ ಡೇಟಾಬೇಸ್ಗಳು ಐಚ್ಛಿಕವಲ್ಲ. ಅವು ಮೂಲಭೂತವಾದವುಗಳು.
-
ಎಂಟರ್ಪ್ರೈಸ್ AI ಗಾಗಿ RAG ಅನ್ನು ಜಾರಿಗೊಳಿಸುತ್ತಿದ್ದರೆ: ವೆಕ್ಟರ್ ಡೇಟಾಬೇಸ್ ಇಲ್ಲದೆ ನೀವು ಇದನ್ನು ಪರಿಣಾಮಕಾರಿಯಾಗಿ ಮಾಡಲು ಸಾಧ್ಯವೇ ಇಲ್ಲ.
-
ಸೆಮ್ಯಾಂಟಿಕ್ ಸರ್ಚ್ನಲ್ಲಿ ಕೆಲಸ ಮಾಡುತ್ತಿದ್ದರೆ: ಇದು ಮುಖ್ಯ ತಂತ್ರಜ್ಞಾನವಾಗಿದೆ.
-
ಅನೋಮಲಿ ಡಿಟೆಕ್ಷನ್ ಸಿಸ್ಟಮ್ಗಳನ್ನು ನಿರ್ಮಿಸುತ್ತಿದ್ದರೆ: ವೆಕ್ಟರ್ ಕ್ಲಸ್ಟರಿಂಗ್ ಸಾಬೀತಾದ ವಿಧಾನವಾಗಿದೆ.
ತಂತ್ರಜ್ಞಾನವು ಪರಿಪಕ್ವವಾಗಿದೆ. ಇಕೋಸಿಸ್ಟಮ್ ಪ್ರಬಲವಾಗಿದೆ. ನಿಜವಾದ ಕೆಲಸವು ವಿವರಗಳಲ್ಲಿದೆ: ಸರಿಯಾದ ಎಂಬೆಡ್ಡಿಂಗ್ ಮಾಡೆಲ್ ಅನ್ನು ಆಯ್ಕೆ ಮಾಡುವುದು, ನಿಮ್ಮ ಡೇಟಾವನ್ನು ಸರಿಯಾಗಿ ಸಿದ್ಧಪಡಿಸುವುದು ಮತ್ತು ನೈಜ-ಪ್ರಪಂಚದ ಕಾರ್ಯಕ್ಷಮತೆಯ ಆಧಾರದ ಮೇಲೆ ಪುನರಾವರ್ತಿಸುವುದು.
ಸಣ್ಣದಾಗಿ ಪ್ರಾರಂಭಿಸಿ. ನೀವು ಇದಕ್ಕೆ ಹೊಸಬರಾಗಿದ್ದರೆ ಮ್ಯಾನೇಜ್ಡ್ ಸೇವೆಯೊಂದಿಗೆ ಪೈಲಟ್ ಮಾಡಿ. ನೈಜ ಬಳಕೆದಾರರ ಪ್ರತಿಕ್ರಿಯೆಯ ಆಧಾರದ ಮೇಲೆ ಪುನರಾವರ್ತಿಸಿ. ವೆಕ್ಟರ್ ಡೇಟಾಬೇಸ್ ಕ್ರಾಂತಿ ಬರಬೇಕಿಲ್ಲ—ಅದು ಇಲ್ಲೇ ಇದೆ.
2026 ರಲ್ಲಿ ಪ್ರಶ್ನೆಯು ನೀವು ವೆಕ್ಟರ್ ಡೇಟಾಬೇಸ್ಗಳನ್ನು ಬಳಸಬೇಕೇ ಎಂಬುದಲ್ಲ. ನೀವು ಅವುಗಳನ್ನು ಪರಿಣಾಮಕಾರಿಯಾಗಿ ಬಳಸುತ್ತಿದ್ದೀರಾ ಎಂಬುದಾಗಿದೆ.
ಪ್ರಮುಖ ಮುಖ್ಯಾಂಶಗಳು
- ವೆಕ್ಟರ್ ಎಂಬೆಡ್ಡಿಂಗ್ಗಳು ಅರ್ಥವನ್ನು ಗಣಿತವಾಗಿ ಪರಿವರ್ತಿಸುತ್ತವೆ. ಸಮಾನ ಅರ್ಥಗಳನ್ನು ಹೊಂದಿರುವ ಪದಗಳು ಮತ್ತು ಪರಿಕಲ್ಪನೆಗಳು ಹೈ-ಡೈಮೆನ್ಷನಲ್ ಸ್ಪೇಸ್ನಲ್ಲಿ ಒಟ್ಟಿಗೆ ಗುಂಪಾಗುತ್ತವೆ.
- ವೆಕ್ಟರ್ ಡೇಟಾಬೇಸ್ಗಳು ನಿಖರವಾದ ಹೊಂದಾಣಿಕೆಯಿಂದ ಅಲ್ಲ, ಸಿಮಿಲಾರಿಟಿ ಮೂಲಕ ಹುಡುಕುತ್ತವೆ. ಇದು ದೊಡ್ಡ ಪ್ರಮಾಣದಲ್ಲಿ ಸೆಮ್ಯಾಂಟಿಕ್ ಗ್ರಹಿಕೆಯನ್ನು ಸಕ್ರಿಯಗೊಳಿಸುತ್ತದೆ.
- RAG (Retrieval-Augmented Generation) ಎನ್ನುವುದು LLM ನ ಭ್ರಮೆಯ ಸಮಸ್ಯೆಯನ್ನು ಪರಿಹರಿಸಿದೆ ವೆಕ್ಟರ್ ಸರ್ಚ್ ಮೂಲಕ ಭಾಷಾ ಮಾದರಿಗಳನ್ನು ನೈಜ ಡೇಟಾದಲ್ಲಿ ಆಧಾರವಾಗಿಸುವ ಮೂಲಕ.
- ತಂತ್ರಜ್ಞಾನದ ಆಯ್ಕೆಗಿಂತ ಅದರ ಅನುಷ್ಠಾನವು ಹೆಚ್ಚು ಮುಖ್ಯವಾಗಿದೆ. ನಿಮ್ಮ ಎಂಬೆಡ್ಡಿಂಗ್ ಮಾಡೆಲ್, ಡೇಟಾ ತಯಾರಿ ಮತ್ತು ಚಂಕಿಂಗ್ ತಂತ್ರವು ಯಶಸ್ಸು ಅಥವಾ ವೈಫಲ್ಯವನ್ನು ನಿರ್ಧರಿಸುತ್ತದೆ.
- ವೆಕ್ಟರ್ ಡೇಟಾಬೇಸ್ಗಳು ಸಾಂಪ್ರದಾಯಿಕ ಡೇಟಾಬೇಸ್ಗಳಿಗೆ ಪೂರಕವಾಗಿವೆ, ಅವುಗಳನ್ನು ಬದಲಾಯಿಸುವುದಿಲ್ಲ. ಪ್ರೊಡಕ್ಷನ್ ಸಿಸ್ಟಮ್ಗಳಲ್ಲಿ ಎರಡನ್ನೂ ಬಳಸಿ.
- 2026 ರಲ್ಲಿ ಇಕೋಸಿಸ್ಟಮ್ ಪರಿಪಕ್ವವಾಗಿದೆ. ಮ್ಯಾನೇಜ್ಡ್ ಸೇವೆಗಳು (Pinecone) ಅಥವಾ ಮುಕ್ತ-ಮೂಲ ಪರಿಹಾರಗಳು (Milvus, Qdrant) ಎರಡೂ ಕೆಲಸ ಮಾಡುತ್ತವೆ. ನಿಮ್ಮ ಕಾರ್ಯಾಚರಣೆಯ ಸಾಮರ್ಥ್ಯದ ಆಧಾರದ ಮೇಲೆ ಆಯ್ಕೆಮಾಡಿ.
- ನಿರಂತರವಾಗಿ ಉಸ್ತುವಾರಿ ವಹಿಸಿ, ಪುನರಾವರ್ತಿಸಿ ಮತ್ತು ಸುಧಾರಿಸಿ. ಇದು ಪ್ರೊಡಕ್ಷನ್ AI, ಇದು ಒಂದು ಬಾರಿಯ ನಿಯೋಜನೆಯಲ್ಲ.
ಜೂನ್ 2026 ರಲ್ಲಿ ಬರೆಯಲಾಗಿದೆ. ವೆಕ್ಟರ್ ಡೇಟಾಬೇಸ್ ತಂತ್ರಜ್ಞಾನವು ವಿಕಸನಗೊಳ್ಳುತ್ತಲೇ ಇರುತ್ತದೆ. ಇಲ್ಲಿ ವಿವರಿಸಲಾದ ಮೂಲಭೂತ ವಿಷಯಗಳು ಸ್ಥಿರವಾಗಿರುತ್ತವೆ, ಆದರೆ ಅನುಷ್ಠಾನದ ವಿವರಗಳು ಮಾಸಿಕ ಬದಲಾಗುತ್ತವೆ. ನಿಮ್ಮ ಪೂರೈಕೆದಾರರ ದಸ್ತಾವೇಜು ಮತ್ತು ಸಮುದಾಯದ ಅತ್ಯುತ್ತಮ ಅಭ್ಯಾಸಗಳೊಂದಿಗೆ ಅಪ್ಡೇಟ್ ಆಗಿರಿ.
Linux Server Hardening Checklist
30 practical steps to take a fresh Linux box from default to defensible. Enter your email — you'll get the PDF instantly, plus new posts on Linux, security & AI.
Free. No spam — unsubscribe in one click.
Responses
Sign in to leave a response.